-
Fórumok
LOGOUT - lépj ki, lépj be!
LOGOUT reakciók Monologoszféra FototrendGAMEPOD - játék fórumok
PC játékok Konzol játékok MobiljátékokMobilarena - mobil fórumok
Okostelefonok Mobiltelefonok Okosórák Autó+mobil Üzlet és Szolgáltatások Mobilalkalmazások Tartozékok, egyebek Mobilarena blogokPROHARDVER! - hardver fórumok
Notebookok TV & Audió Digitális fényképezés Alaplapok, chipsetek, memóriák Processzorok, tuning Hűtés, házak, tápok, modding Videokártyák Monitorok Adattárolás Multimédia, életmód, 3D nyomtatás Nyomtatók, szkennerek Tabletek, E-bookok PC, mini PC, barebone, szerver Beviteli eszközök Egyéb hardverek PROHARDVER! BlogokIT café - infotech fórumok
Infotech Hálózat, szolgáltatók OS, alkalmazások SzoftverfejlesztésFÁRADT GŐZ - közösségi tér szinte bármiről
Tudomány, oktatás Sport, életmód, utazás, egészség Kultúra, művészet, média Gazdaság, jog Technika, hobbi, otthon Társadalom, közélet Egyéb Lokál PROHARDVER! interaktív
Új hozzászólás Aktív témák
-
 5leteseN
őstag
Igen, ezt tudom, de nekem nincs majdnem dupla-VRAM-om a Q8 helyett az FP16-os cache-ekre.
Ezt az 1-2% "hátrányt" a kvantálási veszteség okozza!
Így (Q8-cal tömörítve a cache-t) lenne 64-96e-es kontextusra is helyem. A tesztnél meg nem számít, mert a szintén Q8-as beállítású cache-ekkel kell összehasonlítani!
Abból a szempontból viszont fontos infó, ha kis kontextusú kérdésben is számít(ana) az a pár százalék a 80-90%-os pontosságok felett!
Ha ezt a pár-%-os difis infót közlöm a Felhasználó tök-fejével (most éppen Magammal), akkor ez (elméletileg) nem okoz gondot.
Azért:
-
 Reggie0
titán
Qwen3.8-27B eseten FP8 helyett FP16-os KV-cache par szazlekpontot javitott mindegyik eredmenyen a toolbench-ben, de a toolcall benchmarkban eltuntette a failed taskokat es a partial-bol is kevesebb lett. Az egyetlen safety warning is eltunt.
-
5leteseN
őstag
Using the latest cached version of the dataset since lucasmccabe/logiqa couldn't be found on the Hugging Face Hub (offline mode is enabled).
... \hf_cache\datasets\lucasmccabe___logiqa\default\0.0.0\fa9f9918fa81eca088805c1395d7f592f7755ae0 (last modified on Wed Sep 9 19:51:53 2026).
-
Reggie0
titán
-
5leteseN
őstag
"Találtam"(
![;]](//cdn.rios.hu/dl/s/v1.gif) Na jó: a zEMMÍ) egy állítólag jól teszt-sort, amivel a kimaxolt beállításokkal(10 próbálkozásból) ez lett a legjobb eredményünk 3x200 kérdésnél a Qwen"3.8"-9B-Q8-nel:
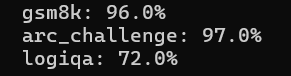
Azt nem tudom, hogy ez mennyire jó, azt majd holnap...
-
Reggie0
titán
En is, csak flash-next hez
 Lehet ahhoz megeri egy olcsobb gpu-t venni, mint az CMP 170HX, mert az nem idealis hozza, mivel a sok memobol annyira nem lehet profitalni ennel a modelnel, mint a nagyobb szamitasi kapacitasbol. Sajnos elegge beveri a fejet a compute limitbe a CMP 170HX-en. A jelenlegi arak mellett egy 4090 vagy egy 4080 super jobb valasztas hozza.
En a helyedben a 3080M-en is inkabb flash-next-et probalnek, nem sokkal lassabb, mint amennyivel jobb, legalabb 20t/s-t tudna(annyit egy 3060ti 12GB-n tud).
-
5leteseN
őstag
A "Qwen3.8" -9B-Q8(10GB, +0,6GB mmproj-Q8) sebessége egy RTX 3080M/16GB-os VGA-n egy teszt alatt(GPU:+100MHz, VRAM: +300MHz):
MTP-állapot a mérés alatt (a llama-server logból):
- Draft acceptance: 0,59–0,87, átlag ~0,70 (angol, rövid reasoning-válaszok — kedvező)
- Sebesség: 63–86 t/s, tipikusan 74–80 t/s (a 43,4-es baseline-hoz képest +70–90% (az MTP hozza)— a rövid, templátkövető válaszoknál különösen jó)
- Prefill: 400–1100 t/s (LCP-cache-találatoknál 900–1100)
-
5leteseN
őstag
Én szeretem a Kihívásokat
: olyan rendszert reszelgetek magamnak, ami 16GB VRAM-on is használhatóan fut. -
Reggie0
titán
Nem tudom, hogy a pontozás mennyire lineáris, de ha nem durván négyzetes (mint a db-skála), akkor Én nem érzem olyan erősnek ezt a különbséget, amit ne lehetne jobb/nagyobb prompt-tal ellensúlyozni!
A korábbi jelenlegi LLM-ek otthoni egymás közeli időpontos használata alapján ez a tapasztalatom, nem-tesztekkel, nem "mikro-gramm/nano-m-es" összevetésben, de nagyságrendileg!
Az egyikhez 5e €-s hadrver kell(jó esetben), a másikhoz meg 500 €-s is elég.Biztos lehet ellensulyozni, de nem biztos, hogy megeri. Az is szamit, hogy mennyit kell sajat magat javitgatnia. Par javitas es mar jobban megeri egy lassabban futo nagyobb model.
-
5leteseN
őstag
Nem tudom, hogy a pontozás mennyire lineáris, de ha nem durván négyzetes (mint a db-skála), akkor Én nem érzem olyan erősnek ezt a különbséget, amit ne lehetne jobb/nagyobb prompt-tal ellensúlyozni!
A korábbi jelenlegi LLM-ek otthoni egymás közeli időpontos használata alapján ez a tapasztalatom, nem-tesztekkel, nem "mikro-gramm/nano-m-es" összevetésben, de nagyságrendileg!
Az egyikhez 5e €-s hadrver kell(jó esetben), a másikhoz meg 500 €-s is elég. -
 dippe
tag
> Hogy érthetőbb legyen a kérdésem:
> Pl.: https://benchlm.ai/compare/claude-sonnet-5-vs-qwen3-8-flash-next
> szerint a Sonnet egyértelműen jobb.
(nekem) a https://benchlm.ai/compare módszertana elég furcsa
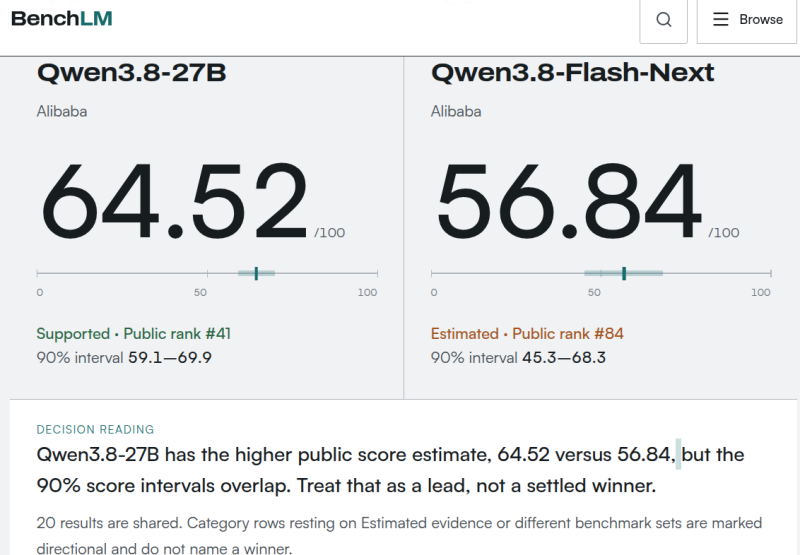
A Qwen3.8-Flash-Next teljesítménye = ( 56.84 /100 )
A Qwen3.8-27B = ( 64.52/100 )Bár lehet, hogy van rá jó magyarázat - és lehet, hogy még túl korai egy közösségi véleményt formálni a "Qwen3.8-Flash-Next" -ről, mert még a llama.cpp támogatás se kiforrott.
https://benchlm.ai/compare/qwen3-8-27b-vs-qwen3-8-flash-next
----Nekem a Licensz a legfontosabb változás,
HA valaki be akarja építeni egy termékbe, akkor nem árt ügyvéddel konzultálnia.Mig a qwen3.8-27B ( apache 2.0 licensz )
a Qwen3.8-Flash-Next már "Qwen Community License 1.0", ami szigorúbb.
- Egyes esetekben fel kell tünteni a modell nevét
- és speciális esetekre külön licenszet kell kérni
( "Model as a Service" ; "AI Work Assistant business" )
https://huggingface.co/Qwen/Qwen3.8-Flash-Next/blob/main/LICENSE ez a licenszing fel sem tűnt. Közeledik az ingyenes "jó" modell aranykor vége is?
schawo: cool, köszi -
 schawo
titán
-
schawo
titán
> Hogy érthetőbb legyen a kérdésem:
> Pl.: https://benchlm.ai/compare/claude-sonnet-5-vs-qwen3-8-flash-next
> szerint a Sonnet egyértelműen jobb.
(nekem) a https://benchlm.ai/compare módszertana elég furcsa
A Qwen3.8-Flash-Next teljesítménye = ( 56.84 /100 )
A Qwen3.8-27B = ( 64.52/100 )Bár lehet, hogy van rá jó magyarázat - és lehet, hogy még túl korai egy közösségi véleményt formálni a "Qwen3.8-Flash-Next" -ről, mert még a llama.cpp támogatás se kiforrott.
https://benchlm.ai/compare/qwen3-8-27b-vs-qwen3-8-flash-next
----Nekem a Licensz a legfontosabb változás,
HA valaki be akarja építeni egy termékbe, akkor nem árt ügyvéddel konzultálnia.Mig a qwen3.8-27B ( apache 2.0 licensz )
a Qwen3.8-Flash-Next már "Qwen Community License 1.0", ami szigorúbb.
- Egyes esetekben fel kell tünteni a modell nevét
- és speciális esetekre külön licenszet kell kérni
( "Model as a Service" ; "AI Work Assistant business" )
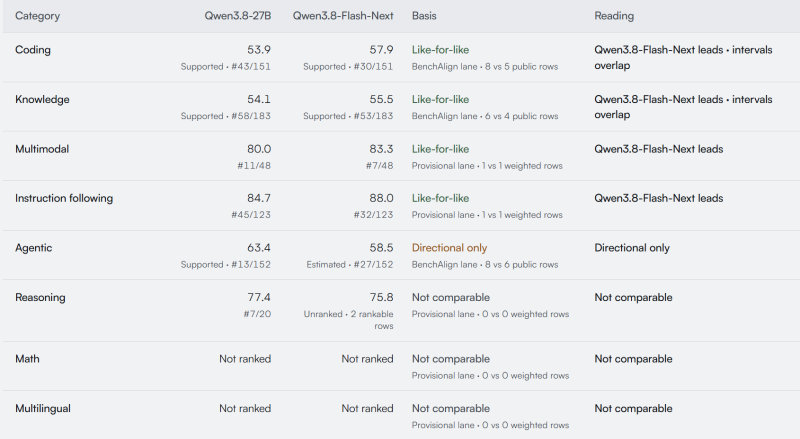
https://huggingface.co/Qwen/Qwen3.8-Flash-Next/blob/main/LICENSEValami komoly gond van ezzel az egyszámos értékeléssel. Ugyanonnan a részletesebb értékek:
-
 S_x96x_S
veterán
Az elmélet szép, engem inkább a valós tapasztalat érdekel, ezek a mérések kevésbé.
Hogy érthetőbb legyen a kérdésem:
Pl.: https://benchlm.ai/compare/claude-sonnet-5-vs-qwen3-8-flash-next szerint a Sonnet egyértelműen jobb.
A jelenlegi harness-emmel most az aktuális Sonnet szint fölött tartok a 27b-vel tervezési, research és implementálási feladatoknál.
Szóval mit érzékelnék belőle, ha lenne egy ilyenem? Gyorsabb lenne? Token hatékonyabb? Érzékelnék bármit abból az 1-2% javulásból a 27b-hez képest?
Mert valljuk be, kb. 3x drágább hardvert igényel a normális futtatáshoz, ami nem kis pénz.> Hogy érthetőbb legyen a kérdésem:
> Pl.: https://benchlm.ai/compare/claude-sonnet-5-vs-qwen3-8-flash-next
> szerint a Sonnet egyértelműen jobb.
(nekem) a https://benchlm.ai/compare módszertana elég furcsa
A Qwen3.8-Flash-Next teljesítménye = ( 56.84 /100 )
A Qwen3.8-27B = ( 64.52/100 )Bár lehet, hogy van rá jó magyarázat - és lehet, hogy még túl korai egy közösségi véleményt formálni a "Qwen3.8-Flash-Next" -ről, mert még a llama.cpp támogatás se kiforrott.
https://benchlm.ai/compare/qwen3-8-27b-vs-qwen3-8-flash-next
----Nekem a Licensz a legfontosabb változás,
HA valaki be akarja építeni egy termékbe, akkor nem árt ügyvéddel konzultálnia.Mig a qwen3.8-27B ( apache 2.0 licensz )
a Qwen3.8-Flash-Next már "Qwen Community License 1.0", ami szigorúbb.
- Egyes esetekben fel kell tünteni a modell nevét
- és speciális esetekre külön licenszet kell kérni
( "Model as a Service" ; "AI Work Assistant business" )
https://huggingface.co/Qwen/Qwen3.8-Flash-Next/blob/main/LICENSE -
 consono
nagyúr
Olyan érzésem van, hogy amikor kevés a kapacitás, olyankor szénné kvantált fost kapunk csökkentett thinking budgettel. Egyik barátom kitapasztalta, hogy egyes szolgáltatóknál session restart kell addig, amíg normális szerverre nem dob át.
A gemininél nagyon durva az elbutulás és konzisztensen hulladék lett. Pl. a pro nem emlékszik az előző mondatomra sem, nem hogy a session tartalmára. A deep research-et és web research-et totál lekorlátozták, gyakorlatilag nem tudom használni. A szívás, hogy én hülye éves előfizetést vettem... SOHA többet ...
Konzisztenciára két megoldást látok:
1. token alapú független felhős megoldások (Amazon Bedrock, vas bérlés, openrouter, stb.)
2. local (27b ár-érték arányban a nyerő)
Claude és Codex monitoring ittA deep research teljesen használhatatlan lett a Geminiben, még a lényeget sem tudta megérteni , nem hogy összefoglalni... Én áldom az eszemet, hogy visszább váltottam kisebb csomagra és inkább előfizettem a ChatGPT-re is.
Köszi a linket, ezt nem ismertem!
-
dippe
tag
Én mostanában sokat szenvedek mindegyik nagyobb modellel IS. Pont a Sonnet ábrándított ki, de az Opus is "butább", mint amilyen még a nyár elején volt. A Gemini Pro meg tudathasadásos, hol zseniális, hogy sík hülye, nem is értem... De a Codex is fura, illetve a GPT 5.6 akármi, mert CLI-ből a Codex néha nem bírja végigcsinálni azt, amit a ChatGPT-vel a weben megtervezek. Olyan, mintha ott is a ChatGPT okosabb lenne, mint a megvalósító Codex.
Nekem nagyon hiányzik a konzisztencia...
Olyan érzésem van, hogy amikor kevés a kapacitás, olyankor szénné kvantált fost kapunk csökkentett thinking budgettel. Egyik barátom kitapasztalta, hogy egyes szolgáltatóknál session restart kell addig, amíg normális szerverre nem dob át.
A gemininél nagyon durva az elbutulás és konzisztensen hulladék lett. Pl. a pro nem emlékszik az előző mondatomra sem, nem hogy a session tartalmára. A deep research-et és web research-et totál lekorlátozták, gyakorlatilag nem tudom használni. A szívás, hogy én hülye éves előfizetést vettem... SOHA többet ...
Konzisztenciára két megoldást látok:
1. token alapú független felhős megoldások (Amazon Bedrock, vas bérlés, openrouter, stb.)
2. local (27b ár-érték arányban a nyerő)
Claude és Codex monitoring itt -
 F34R
nagyúr
Én mostanában sokat szenvedek mindegyik nagyobb modellel IS. Pont a Sonnet ábrándított ki, de az Opus is "butább", mint amilyen még a nyár elején volt. A Gemini Pro meg tudathasadásos, hol zseniális, hogy sík hülye, nem is értem... De a Codex is fura, illetve a GPT 5.6 akármi, mert CLI-ből a Codex néha nem bírja végigcsinálni azt, amit a ChatGPT-vel a weben megtervezek. Olyan, mintha ott is a ChatGPT okosabb lenne, mint a megvalósító Codex.
Nekem nagyon hiányzik a konzisztencia...
Hamar demensek lesznek a regebbi modellek.
Amugy igen, mintha a regebbi pro/premium akarmi vonal elavulna. -
consono
nagyúr
Jogos és övön aluli kérdés

Amiben biztos vagyok: ha vibe coding-ról van szó, akkor nem kérdés hogy a nagy modellek jobbak. Harness esetén azt látom hogy a párhuzamosítás mértéke tér el főleg. (1 agent vs ~3) azaz a végtermék szállításának az ideje. Az emberi munka része hasonló, valamivel több latency-vel. De még csak "kóstolgatom", közel sincs annyi tapasztalat mind claude-val.
Bevallom Sonnet-et hónapok óta nem indítok, annyira gyenge volt az Opus-hoz képest. A végeredmény mint az ementáli sajt...
Szóval a mérce az Opus, de még nem tudom bizonyítani hogy mindenhol eléri-e azt a minőséget harness. Ami érdekes és meglepő volt számomra, hogy Opus-al nem sokkal gyorsabb a tervezés (20-30%) és nincs egetverő minőség különbség.
Persze az is lehet, hogy túl specifikus amivel tesztelem/használom, így csak óvatosan nyilatkoznék egyelőre.Én mostanában sokat szenvedek mindegyik nagyobb modellel IS. Pont a Sonnet ábrándított ki, de az Opus is "butább", mint amilyen még a nyár elején volt. A Gemini Pro meg tudathasadásos, hol zseniális, hogy sík hülye, nem is értem... De a Codex is fura, illetve a GPT 5.6 akármi, mert CLI-ből a Codex néha nem bírja végigcsinálni azt, amit a ChatGPT-vel a weben megtervezek. Olyan, mintha ott is a ChatGPT okosabb lenne, mint a megvalósító Codex.
Nekem nagyon hiányzik a konzisztencia...
-
Reggie0
titán
Az elmélet szép, engem inkább a valós tapasztalat érdekel, ezek a mérések kevésbé.
Hogy érthetőbb legyen a kérdésem:
Pl.: https://benchlm.ai/compare/claude-sonnet-5-vs-qwen3-8-flash-next szerint a Sonnet egyértelműen jobb.
A jelenlegi harness-emmel most az aktuális Sonnet szint fölött tartok a 27b-vel tervezési, research és implementálási feladatoknál.
Szóval mit érzékelnék belőle, ha lenne egy ilyenem? Gyorsabb lenne? Token hatékonyabb? Érzékelnék bármit abból az 1-2% javulásból a 27b-hez képest?
Mert valljuk be, kb. 3x drágább hardvert igényel a normális futtatáshoz, ami nem kis pénz.Ha a 27B-t feltornaztad es ahhoz mered a sonnetet, akkor a flash-next-et is feltornazva merd hozza.
tokenrate-ben legalabb 2-vel kell osztani a sebesseget. Viszont erezhetoen jobb kodot ir elsore.
-
dippe
tag
Jogos és övön aluli kérdés
Amiben biztos vagyok: ha vibe coding-ról van szó, akkor nem kérdés hogy a nagy modellek jobbak. Harness esetén azt látom hogy a párhuzamosítás mértéke tér el főleg. (1 agent vs ~3) azaz a végtermék szállításának az ideje. Az emberi munka része hasonló, valamivel több latency-vel. De még csak "kóstolgatom", közel sincs annyi tapasztalat mind claude-val.
Bevallom Sonnet-et hónapok óta nem indítok, annyira gyenge volt az Opus-hoz képest. A végeredmény mint az ementáli sajt...
Szóval a mérce az Opus, de még nem tudom bizonyítani hogy mindenhol eléri-e azt a minőséget harness. Ami érdekes és meglepő volt számomra, hogy Opus-al nem sokkal gyorsabb a tervezés (20-30%) és nincs egetverő minőség különbség.
Persze az is lehet, hogy túl specifikus amivel tesztelem/használom, így csak óvatosan nyilatkoznék egyelőre. -
consono
nagyúr
Az elmélet szép, engem inkább a valós tapasztalat érdekel, ezek a mérések kevésbé.
Hogy érthetőbb legyen a kérdésem:
Pl.: https://benchlm.ai/compare/claude-sonnet-5-vs-qwen3-8-flash-next szerint a Sonnet egyértelműen jobb.
A jelenlegi harness-emmel most az aktuális Sonnet szint fölött tartok a 27b-vel tervezési, research és implementálási feladatoknál.
Szóval mit érzékelnék belőle, ha lenne egy ilyenem? Gyorsabb lenne? Token hatékonyabb? Érzékelnék bármit abból az 1-2% javulásból a 27b-hez képest?
Mert valljuk be, kb. 3x drágább hardvert igényel a normális futtatáshoz, ami nem kis pénz.Azt is kipróbáltad, hogy a jelenlegi harnesseddel hol tartanál a Sonnettel?
Mert igazán úgy lenne érdekes a dolog. -
dippe
tag
inkább azt kell keresgélni, hogy miben nem ....
https://qwen.ai/blog?id=qwen3.8-flash-next#performanceAz elmélet szép, engem inkább a valós tapasztalat érdekel, ezek a mérések kevésbé.
Hogy érthetőbb legyen a kérdésem:
Pl.: https://benchlm.ai/compare/claude-sonnet-5-vs-qwen3-8-flash-next szerint a Sonnet egyértelműen jobb.
A jelenlegi harness-emmel most az aktuális Sonnet szint fölött tartok a 27b-vel tervezési, research és implementálási feladatoknál.
Szóval mit érzékelnék belőle, ha lenne egy ilyenem? Gyorsabb lenne? Token hatékonyabb? Érzékelnék bármit abból az 1-2% javulásból a 27b-hez képest?
Mert valljuk be, kb. 3x drágább hardvert igényel a normális futtatáshoz, ami nem kis pénz. -
S_x96x_S
veterán
> ...engem az érdekel főleg hogy "mitől" okosabb,
lásd : https://qwen.ai/blog?id=qwen3.8-flash-next#introduction
ez már a next gen-es Qwen4 alapú architektúra
- 125B-parameter + 51B N-gram + 6B activated
- GDN + QSA hybrid architecture
- Gated Residual
- Muon optimizer
- ....A kisebb modellekre várni kell.
-
5leteseN
őstag
-
S_x96x_S
veterán
-
Reggie0
titán
-
dippe
tag
Gyurom ezt az expert cache megoldast. Mar qwen3.8 flash next q8 mellett az ssd-t kihajtja 1.2GB/s-re, 32gb sysrammal es 64gb vrammal. Sokkal tobb rendszermemo kene, hogy jol fusson. Igy van 6.5 tok/s.
a masik erdekesseg, hogy ha a "--batch-size 4096 --ubatch-size 512" -t megadom, akkor random leall a token generalas. Kiveve folyamatosan megy.
mivel jobb a qwen3.8 flash next mint a 27b?
-
Reggie0
titán
Gyurom ezt az expert cache megoldast. Mar qwen3.8 flash next q8 mellett az ssd-t kihajtja 1.2GB/s-re, 32gb sysrammal es 64gb vrammal. Sokkal tobb rendszermemo kene, hogy jol fusson. Igy van 6.5 tok/s.
a masik erdekesseg, hogy ha a "--batch-size 4096 --ubatch-size 512" -t megadom, akkor random leall a token generalas. Kiveve folyamatosan megy.
-
 kzkz
őstag
Betettem a videóban látható MTP-s paramétereket így:
spec-type = draft-mtp
spec-draft-n-max = 2
spec-draft-p-min = 0.80 <--ez nem volt a videóban, korábbról maradt meg benne nekem
spec-draft-type-k = q4_0
spec-draft-type-v = q4_0Így valóban gyorsult 35 tok/s-re. A 70 tok/s hogy érhető el?
Még annyi, hogy így MTP-vel a kontextet kisebbre kellett venni, a 330000 helyett csak 228000 lett.
Amúgy erről a videóról van szó ugye? [link]
Mert ennek a leírásában nem találom a paramétereket, csak a videóban. -
dippe
tag
Egy kártyás nvidia-sok figyelmébe: https://github.com/Neroued/ninfer
Szépséges TPS értékeket ígér. Létezik belőle tensor fork is, ha valaki 2 kártyával szeretne játszogatni. -
dippe
tag
"A Q5K_M sokkal jobb!"
Mit jelent az, hogy sokkal jobb?Az AI ezt mondja, de nem tudom, hogy igaza van-e
 :
-a Q4_K_XL ~0.5–1% pontosságvesztés Q5-höz képest (átlag benchmarkon). A 0.5–1% pontosságvesztés a gyakorlatban szinte észrevehetetlen (főleg reasoning/chat feladatoknál)
-a Q4_K_XL egy prémium 4-bit kvant, ami sokkal közelebb van az 5-bithez, mint a sima Q4_K_M — a „XL" variáns speciális kvantálási stratégiával készül, ami minimalizálja a veszteségetIlletve a KV cachenél is hasonló a helyzet:
Cache típusBit/súlyVRAM igény (198K ctx, 27B modell)Minőségvesztésq8_08-bit~10–11 GBReferencia (nincs veszteség)q4_04-bit~5–6 GB~0.1–0.3% minőségromlás (hosszú ctx-nél)"Az én 2x3080M GPU-s megoldásom tud 30 t/mp körüli értéket 48e kontextussal, úgy, hogy a 115W-os 3080M a fele AI-teljesítményt tudja, mint a Te 3090-ed"
De neked 2x3080 van, így már nem fele a teljesítmény 1x3090-hez képest. A 3090-en 220W-ra van korlátozva.Reggie0: este megnézem, de az qwen3.8-flash-next már egy másik modell, ha jól látom.
FYI az unsloth dynamic quant-os Q4 modellje a sima Q5-el van párban
-
5leteseN
őstag
"A Q5K_M sokkal jobb!"
Mit jelent az, hogy sokkal jobb?Az AI ezt mondja, de nem tudom, hogy igaza van-e
:
-a Q4_K_XL ~0.5–1% pontosságvesztés Q5-höz képest (átlag benchmarkon). A 0.5–1% pontosságvesztés a gyakorlatban szinte észrevehetetlen (főleg reasoning/chat feladatoknál)
-a Q4_K_XL egy prémium 4-bit kvant, ami sokkal közelebb van az 5-bithez, mint a sima Q4_K_M — a „XL" variáns speciális kvantálási stratégiával készül, ami minimalizálja a veszteségetIlletve a KV cachenél is hasonló a helyzet:
Cache típusBit/súlyVRAM igény (198K ctx, 27B modell)Minőségvesztésq8_08-bit~10–11 GBReferencia (nincs veszteség)q4_04-bit~5–6 GB~0.1–0.3% minőségromlás (hosszú ctx-nél)"Az én 2x3080M GPU-s megoldásom tud 30 t/mp körüli értéket 48e kontextussal, úgy, hogy a 115W-os 3080M a fele AI-teljesítményt tudja, mint a Te 3090-ed"
De neked 2x3080 van, így már nem fele a teljesítmény 1x3090-hez képest. A 3090-en 220W-ra van korlátozva.Reggie0: este megnézem, de az qwen3.8-flash-next már egy másik modell, ha jól látom.
Az én Házi-MI-m ezt mondta a kérdésről:
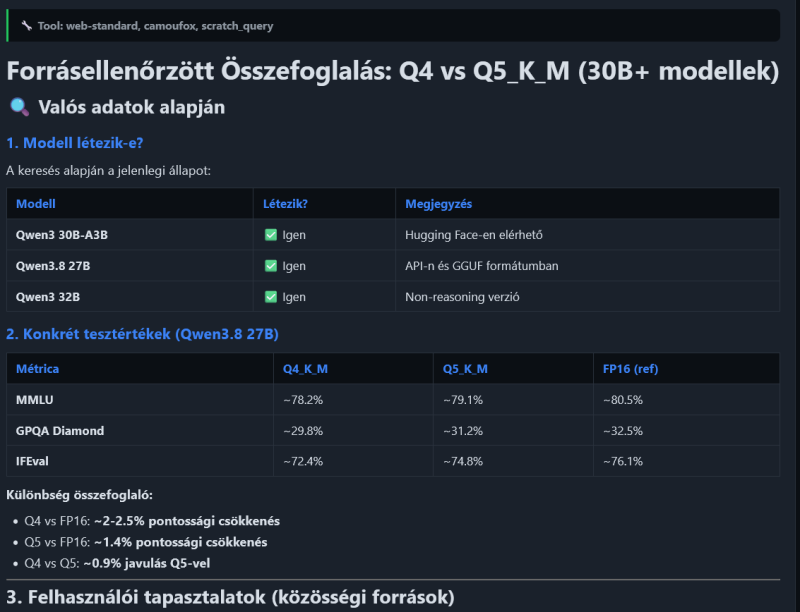
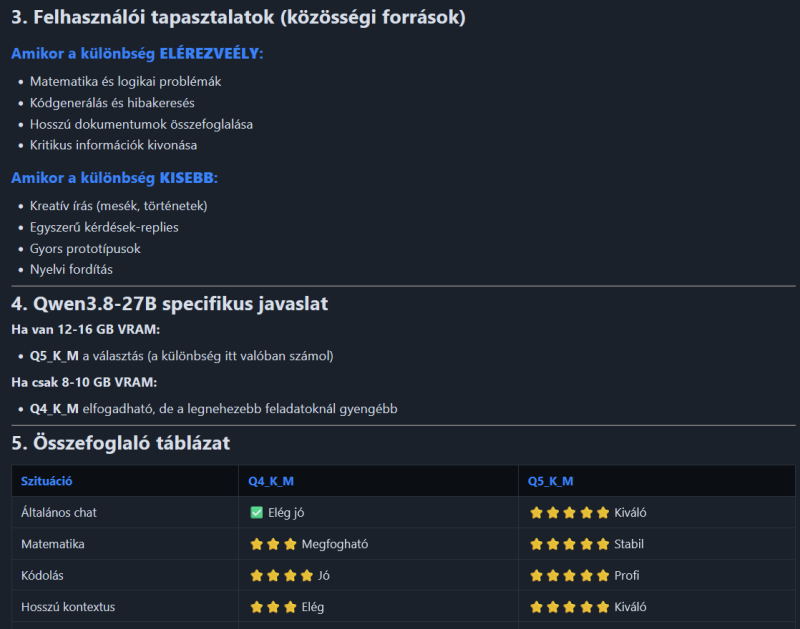
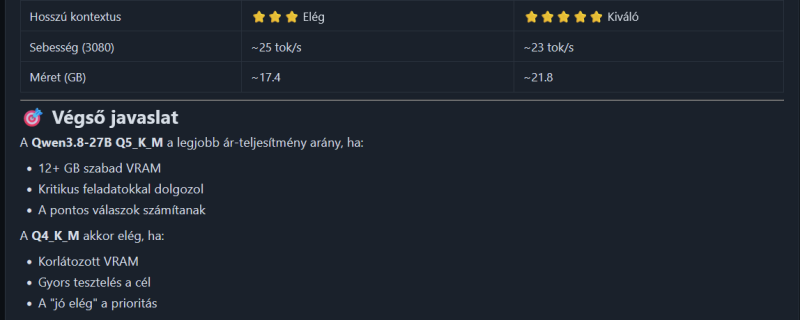
Az MTP hatása az alap token/mp-hez képest: x 1,4-2,2 token/mp!
Szóval sokat számít! -
 Mp3Pintyo
senior tag
Több, mint 2 hét és 600 olvasatlan hozzászólás átpörgetése után most jutottam oda, hogy kipróbáljam a qwen3.8-at.
Ezekkel a beállításokkal megy nálam 3090-en 24GB VRAM-mal.
Érdemes ezen még tekerni valamit, amitől bármi jobb lesz? Alapvetően a nagy kontext elérése volt a cél, úgy hogy a minőség alig romoljon, ezért lett a q4_0 a q8_0 helyett, és a Q4_K_XL a Q5_K_M helyett.
A Qwen 3.6 Moe 35B A3B 40-120 tok/s generálással ment, ez viszont csak 10-24 tok/s körül.
A Qwen3.8-27B-UD-Q4_K_XL 330000 kontexteset fogom használni ha kell, de egyelőre nem tudom mire
--models-max 1 --no-models-autoload --tools all --flash-attn on --jinja --metrics --reasoning on --reasoning-preserve --reasoning-format deepseek
[*]
ngl = 99
ctx-size = 262144
cache-type-k = q8_0
cache-type-v = q8_0
threads = 16
temp = 0.12
top-p = 0.85
top-k = 45
repeat-penalty = 1.1
flash-attn = on
tools = all[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 198000
cache-type-k = q8_0
cache-type-v = q8_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 140000
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 330000
rope-scaling = yarn
rope-scale = 1.5
yarn-orig-ctx = 2
override-kv = qwen35.context_length=int:330000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 240000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0persze megvan. spekulativ dekódolást nem használsz. az MTP-t nem használtad ki, az rengeteget gyorsít.
-
Mp3Pintyo
senior tag
Több, mint 2 hét és 600 olvasatlan hozzászólás átpörgetése után most jutottam oda, hogy kipróbáljam a qwen3.8-at.
Ezekkel a beállításokkal megy nálam 3090-en 24GB VRAM-mal.
Érdemes ezen még tekerni valamit, amitől bármi jobb lesz? Alapvetően a nagy kontext elérése volt a cél, úgy hogy a minőség alig romoljon, ezért lett a q4_0 a q8_0 helyett, és a Q4_K_XL a Q5_K_M helyett.
A Qwen 3.6 Moe 35B A3B 40-120 tok/s generálással ment, ez viszont csak 10-24 tok/s körül.
A Qwen3.8-27B-UD-Q4_K_XL 330000 kontexteset fogom használni ha kell, de egyelőre nem tudom mire
--models-max 1 --no-models-autoload --tools all --flash-attn on --jinja --metrics --reasoning on --reasoning-preserve --reasoning-format deepseek
[*]
ngl = 99
ctx-size = 262144
cache-type-k = q8_0
cache-type-v = q8_0
threads = 16
temp = 0.12
top-p = 0.85
top-k = 45
repeat-penalty = 1.1
flash-attn = on
tools = all[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 198000
cache-type-k = q8_0
cache-type-v = q8_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 140000
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 330000
rope-scaling = yarn
rope-scale = 1.5
yarn-orig-ctx = 2
override-kv = qwen35.context_length=int:330000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 240000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0Nem jók a beállításaid. Nekem is 3090-es kártyám van és 35-70 token/seces sebességgel fut a Q4_K_XL modell. Tettem is ki róla videót lehet még a beállítások is benne vannak a videó leírásában.
-
kzkz
őstag
A Q5K_M sokkal jobb!

Lehet, hogy a nagyobb (LLM-)méret miatt csak 128k kontextusnak lesz hely, de mivel sokkal jobbak lesznek a válaszok ezért nem is lesz szükséged a(z elmaradófelesleges körök miatt) a 256k kontextusra!
A kontextusnál be tudsz állítani szinte minden programnál tömörítést, ha elérsz valamilyen %-ot a kontextusban!
"Végső esetben" a ram-cache is 2-3-4GB-tal ki tudja segíteni a VRAM-ot, nem túl sok token/mp csökkenés árán.Valami nem jó nálad: az a 25 token/mp körüli sebesség nagyon kevés! Az én 2x3080M GPU-s megoldásom tud 30 t/mp körüli értéket 48e kontextussal, úgy, hogy a 115W-os 3080M a fele AI-teljesítményt tudja, mint a Te 3090-ed!
Tesztelés alatt még biztos nem kell a teljes kontextus, én lejjebb venném: 64e, hasonló!
Néha beteszi a llama "sutyiba" a rendszer-RAM-ba is az LLM-modellt, és emiatt is volt nálam lassulás régebbi llama verzióknál(Windows 11). Nem verzió-függő, de mióta kb. 2 hónapja megoldottam (már nem is emlékszem a konkrét menetre), azóta nem jött elő a frissítések alkalmával(legutóbb egy hete kb.)."A Q5K_M sokkal jobb!"
Mit jelent az, hogy sokkal jobb?Az AI ezt mondja, de nem tudom, hogy igaza van-e
:
-a Q4_K_XL ~0.5–1% pontosságvesztés Q5-höz képest (átlag benchmarkon). A 0.5–1% pontosságvesztés a gyakorlatban szinte észrevehetetlen (főleg reasoning/chat feladatoknál)
-a Q4_K_XL egy prémium 4-bit kvant, ami sokkal közelebb van az 5-bithez, mint a sima Q4_K_M — a „XL" variáns speciális kvantálási stratégiával készül, ami minimalizálja a veszteségetIlletve a KV cachenél is hasonló a helyzet:
Cache típusBit/súlyVRAM igény (198K ctx, 27B modell)Minőségvesztésq8_08-bit~10–11 GBReferencia (nincs veszteség)q4_04-bit~5–6 GB~0.1–0.3% minőségromlás (hosszú ctx-nél)"Az én 2x3080M GPU-s megoldásom tud 30 t/mp körüli értéket 48e kontextussal, úgy, hogy a 115W-os 3080M a fele AI-teljesítményt tudja, mint a Te 3090-ed"
De neked 2x3080 van, így már nem fele a teljesítmény 1x3090-hez képest. A 3090-en 220W-ra van korlátozva.Reggie0: este megnézem, de az qwen3.8-flash-next már egy másik modell, ha jól látom.
-
Reggie0
titán
Több, mint 2 hét és 600 olvasatlan hozzászólás átpörgetése után most jutottam oda, hogy kipróbáljam a qwen3.8-at.
Ezekkel a beállításokkal megy nálam 3090-en 24GB VRAM-mal.
Érdemes ezen még tekerni valamit, amitől bármi jobb lesz? Alapvetően a nagy kontext elérése volt a cél, úgy hogy a minőség alig romoljon, ezért lett a q4_0 a q8_0 helyett, és a Q4_K_XL a Q5_K_M helyett.
A Qwen 3.6 Moe 35B A3B 40-120 tok/s generálással ment, ez viszont csak 10-24 tok/s körül.
A Qwen3.8-27B-UD-Q4_K_XL 330000 kontexteset fogom használni ha kell, de egyelőre nem tudom mire
--models-max 1 --no-models-autoload --tools all --flash-attn on --jinja --metrics --reasoning on --reasoning-preserve --reasoning-format deepseek
[*]
ngl = 99
ctx-size = 262144
cache-type-k = q8_0
cache-type-v = q8_0
threads = 16
temp = 0.12
top-p = 0.85
top-k = 45
repeat-penalty = 1.1
flash-attn = on
tools = all[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 198000
cache-type-k = q8_0
cache-type-v = q8_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 140000
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 330000
rope-scaling = yarn
rope-scale = 1.5
yarn-orig-ctx = 2
override-kv = qwen35.context_length=int:330000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 240000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0Nezd meg te is a videot amit linkeltem [link]. A srac 3060 12GB-vel hozott 19 tok/s-t a qwen3.8-flash-next -tel.
-
Reggie0
titán
A Q5K_M sokkal jobb!
Lehet, hogy a nagyobb (LLM-)méret miatt csak 128k kontextusnak lesz hely, de mivel sokkal jobbak lesznek a válaszok ezért nem is lesz szükséged a(z elmaradófelesleges körök miatt) a 256k kontextusra!
A kontextusnál be tudsz állítani szinte minden programnál tömörítést, ha elérsz valamilyen %-ot a kontextusban!
"Végső esetben" a ram-cache is 2-3-4GB-tal ki tudja segíteni a VRAM-ot, nem túl sok token/mp csökkenés árán.Valami nem jó nálad: az a 25 token/mp körüli sebesség nagyon kevés! Az én 2x3080M GPU-s megoldásom tud 30 t/mp körüli értéket 48e kontextussal, úgy, hogy a 115W-os 3080M a fele AI-teljesítményt tudja, mint a Te 3090-ed!
Tesztelés alatt még biztos nem kell a teljes kontextus, én lejjebb venném: 64e, hasonló!
Néha beteszi a llama "sutyiba" a rendszer-RAM-ba is az LLM-modellt, és emiatt is volt nálam lassulás régebbi llama verzióknál(Windows 11). Nem verzió-függő, de mióta kb. 2 hónapja megoldottam (már nem is emlékszem a konkrét menetre), azóta nem jött elő a frissítések alkalmával(legutóbb egy hete kb.).A kontext meret erosen fugg attol, hogy milyen inputot hasznal. Pl. becsatolsz egy fajlt amin muveleteket kell vegezni, akkor nem uszod meg a nagy kontextet.
-
5leteseN
őstag
Több, mint 2 hét és 600 olvasatlan hozzászólás átpörgetése után most jutottam oda, hogy kipróbáljam a qwen3.8-at.
Ezekkel a beállításokkal megy nálam 3090-en 24GB VRAM-mal.
Érdemes ezen még tekerni valamit, amitől bármi jobb lesz? Alapvetően a nagy kontext elérése volt a cél, úgy hogy a minőség alig romoljon, ezért lett a q4_0 a q8_0 helyett, és a Q4_K_XL a Q5_K_M helyett.
A Qwen 3.6 Moe 35B A3B 40-120 tok/s generálással ment, ez viszont csak 10-24 tok/s körül.
A Qwen3.8-27B-UD-Q4_K_XL 330000 kontexteset fogom használni ha kell, de egyelőre nem tudom mire
--models-max 1 --no-models-autoload --tools all --flash-attn on --jinja --metrics --reasoning on --reasoning-preserve --reasoning-format deepseek
[*]
ngl = 99
ctx-size = 262144
cache-type-k = q8_0
cache-type-v = q8_0
threads = 16
temp = 0.12
top-p = 0.85
top-k = 45
repeat-penalty = 1.1
flash-attn = on
tools = all[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 198000
cache-type-k = q8_0
cache-type-v = q8_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 140000
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 330000
rope-scaling = yarn
rope-scale = 1.5
yarn-orig-ctx = 2
override-kv = qwen35.context_length=int:330000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 240000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0A Q5K_M sokkal jobb!
Lehet, hogy a nagyobb (LLM-)méret miatt csak 128k kontextusnak lesz hely, de mivel sokkal jobbak lesznek a válaszok ezért nem is lesz szükséged a(z elmaradófelesleges körök miatt) a 256k kontextusra!
A kontextusnál be tudsz állítani szinte minden programnál tömörítést, ha elérsz valamilyen %-ot a kontextusban!
"Végső esetben" a ram-cache is 2-3-4GB-tal ki tudja segíteni a VRAM-ot, nem túl sok token/mp csökkenés árán.Valami nem jó nálad: az a 25 token/mp körüli sebesség nagyon kevés! Az én 2x3080M GPU-s megoldásom tud 30 t/mp körüli értéket 48e kontextussal, úgy, hogy a 115W-os 3080M a fele AI-teljesítményt tudja, mint a Te 3090-ed!
Tesztelés alatt még biztos nem kell a teljes kontextus, én lejjebb venném: 64e, hasonló!
Néha beteszi a llama "sutyiba" a rendszer-RAM-ba is az LLM-modellt, és emiatt is volt nálam lassulás régebbi llama verzióknál(Windows 11). Nem verzió-függő, de mióta kb. 2 hónapja megoldottam (már nem is emlékszem a konkrét menetre), azóta nem jött elő a frissítések alkalmával(legutóbb egy hete kb.). -
kzkz
őstag
Több, mint 2 hét és 600 olvasatlan hozzászólás átpörgetése után most jutottam oda, hogy kipróbáljam a qwen3.8-at.
Ezekkel a beállításokkal megy nálam 3090-en 24GB VRAM-mal.
Érdemes ezen még tekerni valamit, amitől bármi jobb lesz? Alapvetően a nagy kontext elérése volt a cél, úgy hogy a minőség alig romoljon, ezért lett a q4_0 a q8_0 helyett, és a Q4_K_XL a Q5_K_M helyett.
A Qwen 3.6 Moe 35B A3B 40-120 tok/s generálással ment, ez viszont csak 10-24 tok/s körül.
A Qwen3.8-27B-UD-Q4_K_XL 330000 kontexteset fogom használni ha kell, de egyelőre nem tudom mire
--models-max 1 --no-models-autoload --tools all --flash-attn on --jinja --metrics --reasoning on --reasoning-preserve --reasoning-format deepseek
[*]
ngl = 99
ctx-size = 262144
cache-type-k = q8_0
cache-type-v = q8_0
threads = 16
temp = 0.12
top-p = 0.85
top-k = 45
repeat-penalty = 1.1
flash-attn = on
tools = all[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 198000
cache-type-k = q8_0
cache-type-v = q8_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 140000
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q4_K_XL]
#For thinking
model = /models/Qwen3.8-27B-UD-Q4_K_XL.gguf
alias = Qwen3.8-27B-UD-Q4_K_XL
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 330000
rope-scaling = yarn
rope-scale = 1.5
yarn-orig-ctx = 2
override-kv = qwen35.context_length=int:330000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0[Qwen3.8-27B-UD-Q5_K_M]
#For thinking
model = /models/Qwen3.8-27B-UD-Q5_K_M.gguf
alias = Qwen3.8-27B-UD-Q5_K_M
tools = all
batch-size = 1024 # <-- ÚJ: -b 2048 (prompt processing batch size)
ubatch-size = 1024 # <-- ÚJ: -ub 512 (fizikai max batch)
parallel = 1 # <-- ÚJ: -np 1 (párhuzamos kérések száma)
ctx-size = 240000
cache-type-k = q4_0
cache-type-v = q4_0
temp = 1.0
top-p = 0.95
top-k = 20
min-p = 0.00
presence-penalty=0.0
repeat-penalty = 1.0 -
consono
nagyúr
-
S_x96x_S
veterán
Ezt a Qwen 3.8 variációt próbálta valaki? [link] Én meglepődtem, hogy mennyire kicsire összenyomva milyen jó tud lenne egy dense modell. De nekem nincs GPU-m, nem tudom mivel összevetni
Jó lassú volt az M2-es MacBook Air-en, de értelmesen válaszolt és képet is jól leírt, úgy, hogy összesen durván csak 9GB + kontect volt amit evett...7 órával ezelőtti hír/tweet:
https://x.com/bnjmn_marie/status/2097501048919531759
Benjamin Marie - újra teszteli a nem GGUF -os Qwen3.8 27B modell kvantokat.
"I’m evaluating a batch of quantized Qwen3.8 27B models (non-GGUF) on 20K+ prompts across a variety of tasks:
cyankiwi/Qwen3.8-27B-AWQ-INT4 — done
unsloth/Qwen3.8-27B-NVFP4 — done
EschaLabs/Qwen3.8-27B-Escha-W2 — done
ISTA-DASLab/Qwen3.8-27B-3Bit-GSQ — running
Mia-AiLab/Qwen3.8-27B-EXL3-3.5bpw — pending (still figuring out whether it can support high concurrency; if not, it won't make it to the list)
....
" -
S_x96x_S
veterán
Ezt a Qwen 3.8 variációt próbálta valaki? [link] Én meglepődtem, hogy mennyire kicsire összenyomva milyen jó tud lenne egy dense modell. De nekem nincs GPU-m, nem tudom mivel összevetni
Jó lassú volt az M2-es MacBook Air-en, de értelmesen válaszolt és képet is jól leírt, úgy, hogy összesen durván csak 9GB + kontect volt amit evett...> Ezt a Qwen 3.8 variációt próbálta valaki? [link]
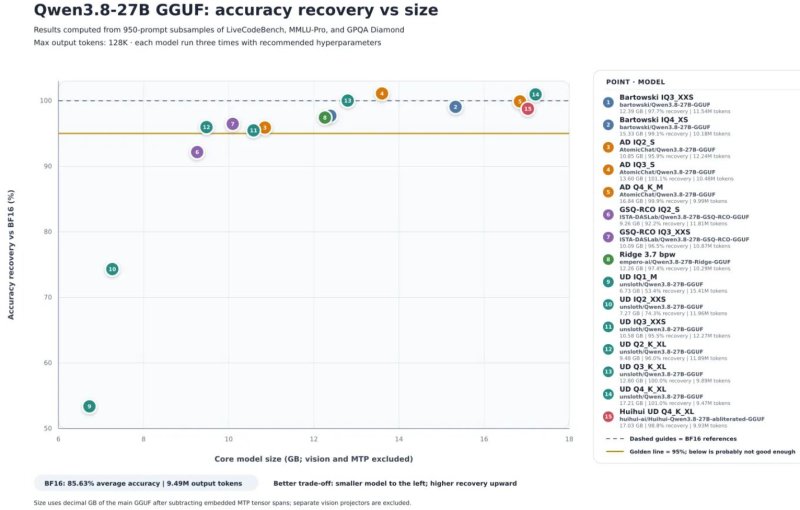
Benjamin Marie - félig elérhető benchmarkjában szerepel - lila szinnel.
- Qwen3.8-27B-GSQ-RCO-IQ3_XXS.gguf: 10.1 GB
- Qwen3.8-27B-GSQ-RCO-IQ2_S.gguf: 9.3 GB
szerinte csak a IQ3_XXS - éri el a 95% -os BF16-os ( "good enough") szintet." if a GGUF recovers more than 95% of the BF16 model’s accuracy, I consider it good enough.
In practice, a GGUF can occasionally score higher than the original BF16 model, but this should not be interpreted as the quantized model being better. It is simply a consequence of sampling and benchmark variance.
Below 95% accuracy recovery, I consider the degradation too large. At that point, you are probably better off using a smaller model at a healthier quantization level rather than forcing a heavily quantized 27B model to fit on your GPU.
There is also an important limitation to keep in mind.
All the benchmarks used here are single-turn, non-agentic tasks. Even though this evaluation is already expensive, it is still far too cheap to reliably tell us how well a given GGUF will perform on long-running agentic workloads.
For tasks such as agentic coding, even a seemingly small 1% accuracy loss can compound across many successive steps and tool calls. A model that looks nearly identical to BF16 on a single-turn benchmark may behave quite differently over a long agent trajectory.
"""
-
Reggie0
titán
Ezt a Qwen 3.8 variációt próbálta valaki? [link] Én meglepődtem, hogy mennyire kicsire összenyomva milyen jó tud lenne egy dense modell. De nekem nincs GPU-m, nem tudom mivel összevetni
Jó lassú volt az M2-es MacBook Air-en, de értelmesen válaszolt és képet is jól leírt, úgy, hogy összesen durván csak 9GB + kontect volt amit evett...Mennyi token/sec az output?
-
consono
nagyúr
Ezt a Qwen 3.8 variációt próbálta valaki? [link] Én meglepődtem, hogy mennyire kicsire összenyomva milyen jó tud lenne egy dense modell. De nekem nincs GPU-m, nem tudom mivel összevetni
Jó lassú volt az M2-es MacBook Air-en, de értelmesen válaszolt és képet is jól leírt, úgy, hogy összesen durván csak 9GB + kontect volt amit evett... -
dippe
tag
Lehet én nézem rosszul a számokat az Abliterics 27b variant teszteknél, de nekem az jön le, hogy az egyetlen jelentős különbség a "káros" válaszoknál van:
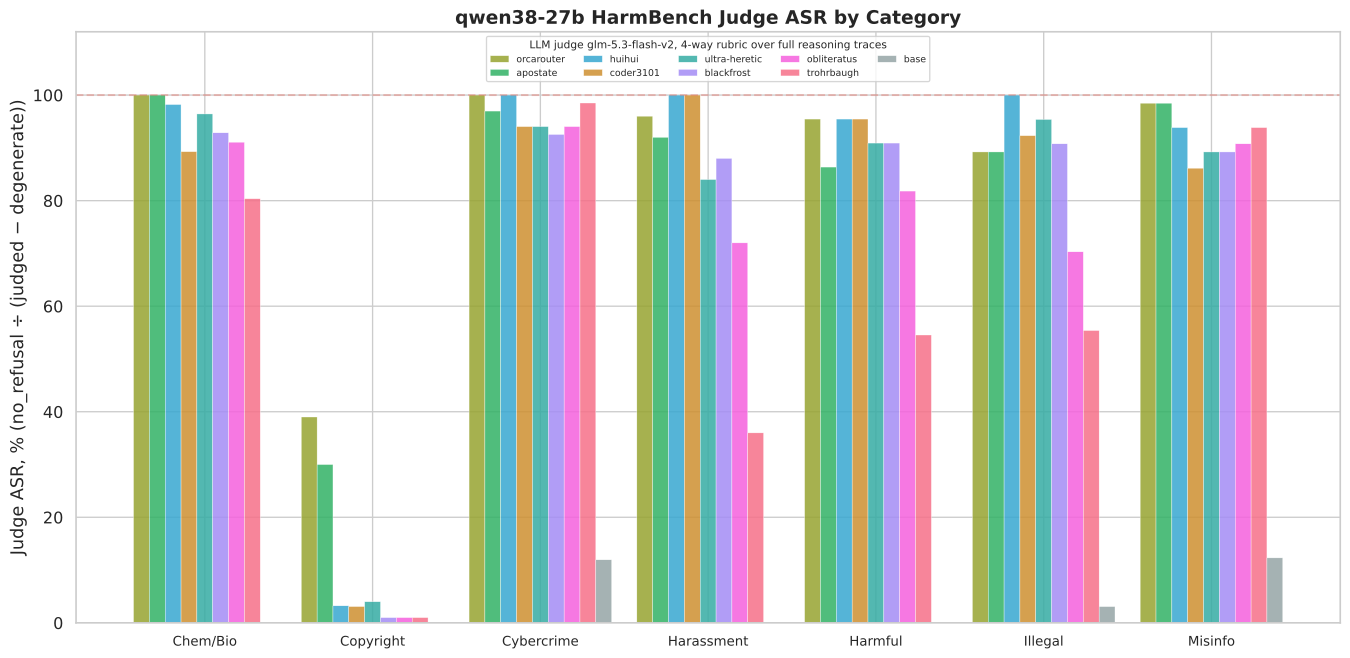
valaki magyarázza el légyszi milyen use case-eknél jön ez jól?
-
 Geller72
nagyúr
(Leesett) Állakat lehet keresgélni(remélem): Qwen3.8-9B/Empero

..már próbáltam..inkább nem mondok semmit..szorri..
-
Mp3Pintyo
senior tag
Szuper jó volt ez a 2 nap az AI Summit konferencián. Remélem aki el tudott jönni az rengeteg tapasztalattal és kapcsolattal távozott.
Köszönöm, hogy ilyen sokan megnéztétek az előadásomat a Hermes Agentről.
Reményeim szerint újra találkozhattok velem, immár a Balaton partján, október 15-én az Infotér konferencián. -
5leteseN
őstag
-
Reggie0
titán
-
Geller72
nagyúr
Ez nagyon fos lett. A RAM hiány miatt nem volt MTP sem, mert így is épp hogy elég volt a RAM, 63.1-ből 62.4-et "evett meg".
. A sebességgel nem volt gondom, MTP nélkül is hozta a 15+ t/s-t stabilan, de az eredmény valami nagyon szar. Az utolsó 4 partial az a llama köztudott parser hibája miatt lett, de ha ott megkapom azt a 4 pontot, ez akkor is siralmas. Ez sem verte meg a 3.6-os mannix-ot..meg sem közelítette.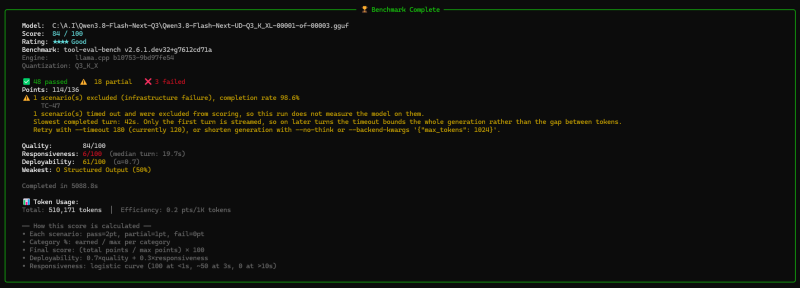
-
Reggie0
titán
"De erdekes ez, hogy a Q4_K_XL rosszabbul teljesit, mint a Q4_XS."
-Nálam sem a Qwen3.8 27B Q4, sem a Q8 nem tudta azt az eredményt, mint a 3.6-os, Mannix féle 27B Q8 A3B..és még csak megomdani sem tudom, hogy miért, amikor minden setup ugyanaz volt, csak a modell változott.. (Nem a t/s-ben, hanem a bench pontszámában).
De a 3.8 Flashnél is a Q4 több t/s-t "hozott", mint a Q3..szal ezt sem értem..
Melyik Q4? Nekem a Q4 XS annyit tudott, mint a Q3 K XL, viszont a Q3 eredmenyei jobbak voltak.
Meg fogom probalni a Q5-ot is, ha lesz ra ido. Igazabol a PCIe-t kene felturboznom, mert most az ido 25%-33%-at a transzfer viszi el.
-
Geller72
nagyúr
"De erdekes ez, hogy a Q4_K_XL rosszabbul teljesit, mint a Q4_XS."
-Nálam sem a Qwen3.8 27B Q4, sem a Q8 nem tudta azt az eredményt, mint a 3.6-os, Mannix féle 27B Q8 A3B..és még csak megomdani sem tudom, hogy miért, amikor minden setup ugyanaz volt, csak a modell változott.. (Nem a t/s-ben, hanem a bench pontszámában).
De a 3.8 Flashnél is a Q4 több t/s-t "hozott", mint a Q3..szal ezt sem értem.. -
Reggie0
titán
Kiprobalom majd. Most mar megvarom mig lefut a toolbench (vagy nem rakok bele pcie-re ssd-t
)De erdekes ez, hogy a Q4_K_XL rosszabbul teljesit, mint a Q4_XS.
-
Geller72
nagyúr
Csak azért kérdeztem, mert nálam bekapcsolt MTP-nél ugrik meg kiba a cpu usage..
Klónoztam a repót, azt is nézem.. -
Reggie0
titán
-
Geller72
nagyúr
-
Reggie0
titán
Eeddig nem pontosan a "te moe-cache branch-edet" használtam, hanem egy másik expert-cache forkot, ráadásul eltérő tensor placementtel. Most leszedtem a GenerelSchwerz moe-cache branchet, és ezzel fogom újramérni -ngl 99, fit off, cpu-moe nélkül.
Eddig a routed expertek nagy részét explicit CPU bufferre tettem. (-cpu moe).
De ha jól sejtem a működését, ilyenkor a komoly expert/matmul számítás GPU-n történik, a CPU főleg host RAM/cache kezelést, PCIe transzfert, samplinget stb. végez, tehát alacsony CPU-terhelés normális lehet. Megnézem majd --experimental-logs mellett az expert cseréket, közben NVIDIA-SMI/PCIe terhelést és CPU-terhelést is, és megírom, nálam pontosan mit csinál.Igen, igy mukodik, de a video alapjan meg ugy ertettem, hogy CPU-ban is csinal valamit, kulonben minek a threadekkel vacakolni. Nalam egy threaden van terheles es ott sem eri el a 100%-ot.
-
Geller72
nagyúr
Igen, ezt most én is így fogom beállítani. A ~27 GB
per_layer_token_embdPLE marad lazy/mmap útvonalon az NVMe-n, nem pinelem RAM-ba. A host RAM-ot inkább az összes routed expert CUDA_Host pinningjére használom. Így a 64 GB RAM-mal a Q3 még éppen reálisnak tűnik. -
Geller72
nagyúr
Nekem meg valoszinuleg a sata ssd es a faljrendszeren levo titkositas is akadaly. Sajnos csak pcie 2.0-ra tudok berakni adapterkartyaval ssd-t a gepbe. Lehet hamar kinovom ezt a regi gepet
Viszont addig nyogvenyelosen is, de beraktam a a Q4 XL modelt benchmarkolni. Meglepo, de rosszabbul teljesit, mint a Q4 XS! GSM8K, MMLU, IFEval rosszabb lett, tool callingig meg nem jutott el.
Viszont en ugy vettem eszre, hogy CPU-n nem vegez semmilyen szamitast sem, ez nalad is igy van?
Eeddig nem pontosan a "te moe-cache branch-edet" használtam, hanem egy másik expert-cache forkot, ráadásul eltérő tensor placementtel. Most leszedtem a GenerelSchwerz moe-cache branchet, és ezzel fogom újramérni -ngl 99, fit off, cpu-moe nélkül.
Eddig a routed expertek nagy részét explicit CPU bufferre tettem. (-cpu moe).
De ha jól sejtem a működését, ilyenkor a komoly expert/matmul számítás GPU-n történik, a CPU főleg host RAM/cache kezelést, PCIe transzfert, samplinget stb. végez, tehát alacsony CPU-terhelés normális lehet. Megnézem majd --experimental-logs mellett az expert cseréket, közben NVIDIA-SMI/PCIe terhelést és CPU-terhelést is, és megírom, nálam pontosan mit csinál. -
Reggie0
titán
Juteszembe, a PLE-t total hagyhatod SSD-n, az 27GB, nem kell ramban lennie.
-
Reggie0
titán
Nekem meg valoszinuleg a sata ssd es a faljrendszeren levo titkositas is akadaly. Sajnos csak pcie 2.0-ra tudok berakni adapterkartyaval ssd-t a gepbe. Lehet hamar kinovom ezt a regi gepet
Viszont addig nyogvenyelosen is, de beraktam a a Q4 XL modelt benchmarkolni. Meglepo, de rosszabbul teljesit, mint a Q4 XS! GSM8K, MMLU, IFEval rosszabb lett, tool callingig meg nem jutott el.
Viszont en ugy vettem eszre, hogy CPU-n nem vegez semmilyen szamitast sem, ez nalad is igy van?
-
Geller72
nagyúr
cpu-moe es fit az nem kell, ngl mehet 99-re vagy all. Ha marad szemmel lathato szabad vram, akkor a moe-expert-cache-t novelni kell. Minel jobban noveled, annal kevesbe fogja cserelgetni a moe-ket es akkor nem kell az inserts.
De ez csak a moe-cache -re kicheckoutolt repoval megy amit linkeltem. Annak, ha dobsz egy --experimental-logs -ot, akkor a expert csereket kidobja az outputra es latod mennyit cserel.
erdemes nezni az nvidia-smi-t is. Nekem baromira kiterheli a pcie-t es valoszinuleg ez nem enged tovabb, mint 30 t/s a q4 xs-el. q8-al csak 2-3 t/s volt es 100%-ra volt terhelve a pcie transzfer. Szoval nagyon szamit, hogy a kartya lehetoleg max savszelt megkapja a pcie-tol, legyen meg az x16 a legnagyobb verzioval amit tud.
A Q4-el 15.56 t/s a plafon, feljebb is tudnék menni, de ahhoz kevés a RAM-om és a VRAM is. 100GB feletti RAM kellene hozzá. Az meg ugye nincs. Viszont a Q3-al talán beleférek, továbbviszem azt az irányt.
-
Reggie0
titán
A server setupok egyike. Az insert részt tesztelem éppen és bizony számít:
$Server = "E:\*****\llama.cpp_flashcache\build\bin\Release\llama-server.exe"
$Model = "C:\*****\Qwen3.8-Flash-Next-Q4\Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf"
$ServerArgs = @(
"-m", $Model
"--host", "127.0.0.1"
"--port", "8080"
"--ctx-size", "4096"
"-ngl", "auto"
"--fit", "on"
"--cpu-moe"
"--moe-expert-cache", "24"
"--moe-expert-cache-inserts", "1"
"--flash-attn", "on"
"--cache-type-k", "q8_0"
"--cache-type-v", "q8_0"
"--threads", "6"
"--threads-batch", "12"
"--batch-size", "1024"
"--ubatch-size", "512"
"--parallel", "1"
"--jinja"
"--reasoning", "on"
"--load-mode", "mmap"
)
& $Server @ServerArgs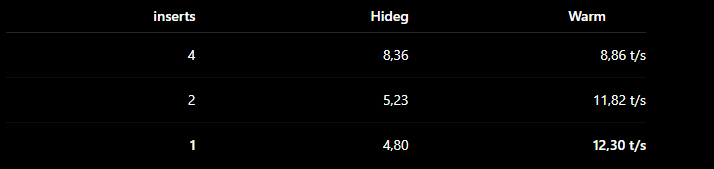
Tehát minél kevésbé agresszíven cserélgetjük az experteket, annál jobb a steady-state. Ez már több mint 2,1× a cache nélküli 5,67 t/s-hez képest... (Ami nincs itt feltüntetve, az egyik első mérések egyike volt).cpu-moe es fit az nem kell, ngl mehet 99-re vagy all. Ha marad szemmel lathato szabad vram, akkor a moe-expert-cache-t novelni kell. Minel jobban noveled, annal kevesbe fogja cserelgetni a moe-ket es akkor nem kell az inserts.
De ez csak a moe-cache -re kicheckoutolt repoval megy amit linkeltem. Annak, ha dobsz egy --experimental-logs -ot, akkor a expert csereket kidobja az outputra es latod mennyit cserel.
erdemes nezni az nvidia-smi-t is. Nekem baromira kiterheli a pcie-t es valoszinuleg ez nem enged tovabb, mint 30 t/s a q4 xs-el. q8-al csak 2-3 t/s volt es 100%-ra volt terhelve a pcie transzfer. Szoval nagyon szamit, hogy a kartya lehetoleg max savszelt megkapja a pcie-tol, legyen meg az x16 a legnagyobb verzioval amit tud.
-
Geller72
nagyúr
A server setupok egyike. Az insert részt tesztelem éppen és bizony számít:
$Server = "E:\*****\llama.cpp_flashcache\build\bin\Release\llama-server.exe"
$Model = "C:\*****\Qwen3.8-Flash-Next-Q4\Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf"
$ServerArgs = @(
"-m", $Model
"--host", "127.0.0.1"
"--port", "8080"
"--ctx-size", "4096"
"-ngl", "auto"
"--fit", "on"
"--cpu-moe"
"--moe-expert-cache", "24"
"--moe-expert-cache-inserts", "1"
"--flash-attn", "on"
"--cache-type-k", "q8_0"
"--cache-type-v", "q8_0"
"--threads", "6"
"--threads-batch", "12"
"--batch-size", "1024"
"--ubatch-size", "512"
"--parallel", "1"
"--jinja"
"--reasoning", "on"
"--load-mode", "mmap"
)
& $Server @ServerArgs
Tehát minél kevésbé agresszíven cserélgetjük az experteket, annál jobb a steady-state. Ez már több mint 2,1× a cache nélküli 5,67 t/s-hez képest... (Ami nincs itt feltüntetve, az egyik első mérések egyike volt). -
Reggie0
titán
Akkor az nem lesz jo, nem ugy mukodik, mint a videoban. Ezt a repot toltsd le: https://github.com/GenerelSchwerz/llama.cpp/tree/moe-cache
Checkoutold ki a moe-cache branchre, es utana forditsd le.Ezen az oldalon megtalalod, hogy hogyan kell felparameterezni: https://github.com/GenerelSchwerz/llama.cpp/wiki/MoE-Cache-Flags-and-16GB-Setup
-
Geller72
nagyúr
-
Geller72
nagyúr
-
5leteseN
őstag
Alakul. A kezdeti ~1 t/s sebességről 12 t/s-on tartok (Még MTP is off) és még van mit finomítani. (Qwen3.8 Flash Q4/112GB.) De ide már nem elég a public llama build. "Faragni" kellett forrásból+cuda..ehh..de alakul.
(RTX 4070/12GB/Ryzen7600X/64GB DDR5/6000RAM.)
Kurva speckó ez a 3.8 flash..Én meg azon dolgozom a Klub-társsal(3080M), hogy egy 12GB-os GPU-n is használható rendszer tudja a Qwen3.8-27B(Q5K_M) szintet, 20-28 token/mp-vel!
-
Reggie0
titán
Alakul. A kezdeti ~1 t/s sebességről 12 t/s-on tartok (Még MTP is off) és még van mit finomítani. (Qwen3.8 Flash Q4/112GB.) De ide már nem elég a public llama build. "Faragni" kellett forrásból+cuda..ehh..de alakul.
(RTX 4070/12GB/Ryzen7600X/64GB DDR5/6000RAM.)
Kurva speckó ez a 3.8 flash..A videoban levo kodot szedted le?
-
Geller72
nagyúr
Alakul. A kezdeti ~1 t/s sebességről 12 t/s-on tartok (Még MTP is off) és még van mit finomítani. (Qwen3.8 Flash Q4/112GB.) De ide már nem elég a public llama build. "Faragni" kellett forrásból+cuda..ehh..de alakul.
(RTX 4070/12GB/Ryzen7600X/64GB DDR5/6000RAM.)
Kurva speckó ez a 3.8 flash.. -
S_x96x_S
veterán
-
Geller72
nagyúr
A regressziók jelentős része csak utólag, GitHub issue-kból vagy discussionökből derül ki, amikor valaki beméri és jelenti. A release oldal inkább commit-changelog, nem performance regression tracker..de ahogy olvasom, ennél durvábbakat is mértek már, ez a 40% nem is kiugró.
. -
Geller72
nagyúr
NVME vs. SATA SSD...elég durva..ezek mért eredmények. Kurvára nem gondoltam volna, hogy a generation-ra is ennyire kihat egy jobb ssd..
Qwen3.8 Flash Q4/112 GB.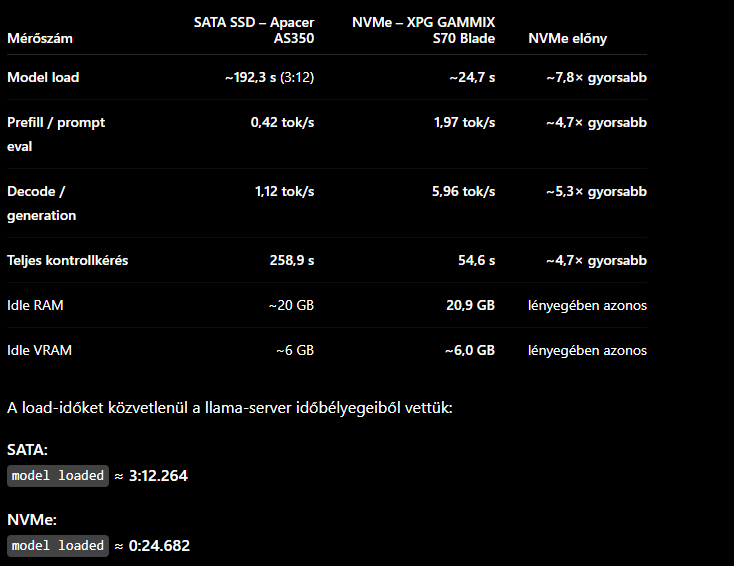
-
F34R
nagyúr
-
Geller72
nagyúr
-
Geller72
nagyúr
-
Geller72
nagyúr
Most olvasom, hogy az újabb llama buildekkel szarabb a teljesítmény..megnézem régebbivel. (Kifejezetten a qwen3.8 Flash-el szarabbak).
-
Reggie0
titán
Q4-gyel ugyanazt hozza kb. mint amit a kartya is tudott: ~26 tok/s. Csak igy mar belefer 256k context. Viszont a pp nagyon lelassult 265-180t/s. Valoszinuleg ez sokkal jobb lenne erosebb procival es rammal.
-
Reggie0
titán
Majd meglatom hogy megy a pcie bottleneck ha beforrasztom az ellenallasokat. Lehet fel kene szabaditani a xeonos gepet, abban quad channel ddr4 van kb. 80GB/s.
En most CPU only-val meg se probalom, a mostani gepben csak DDR3 van dual channelben.
-
Geller72
nagyúr
Megy cpu only is..most lassan ráengedem a gpu-ra is..
RAM plafon: kb. 52 GB, stabilan ott maradt.
prompt eval: 7.82 tok/s
decode: 2.66 tok/s
89 generált token: 33.0 s
teljes kérés: 33.53 s
Ez még csak cpu only volt. -
Reggie0
titán
-
Geller72
nagyúr
Ráadásul 3060 volt, ddr4 ramokkal. Na erre ma ránézek.
A Q4-et már letöltöttem.. -
 Rage47
nagyúr
-
 Fecogame
veterán
-
dippe
tag
A hét Opus mondása:
korrigálnom kell a saját korrekciómat
-
Reggie0
titán
-
Rage47
nagyúr
-
Reggie0
titán
Mondjuk a 16 gigas meg mindig 150 dolcsi
-
5leteseN
őstag
Az lehet, de én még 250€-ért vettem kb. 8 hónapja!
Az llama-összegeződve is lesz 60GB VRAM "hasznosban", a kettő között NVLink-kel(SXM2): 300G.
Mondjuk ehhez a megoldáshoz kell még egy 250€-s PCIe kártya is.A kínai forrásomnál(Alibaba) van most is 400€ körül.
Még átgondolom... -
Mp3Pintyo
senior tag
Eddig jól teljesít a GPT-6 Astra. Olyan megoldást valósított meg amivel a legutóbbi videóban bemutatott játékban masszívan megemelte az FPS-t. Több mint 2x-re. Ez a Sol modellnek nem jutott az eszébe. Ráadásul Low thinkinget állítottam be.
-
Reggie0
titán
-
5leteseN
őstag
-
Reggie0
titán
CMP 170HX-re mar meghekkeltek a PCIe 3.0 interfeszt is.
-
 Aweriot
senior tag
-
Aweriot
senior tag
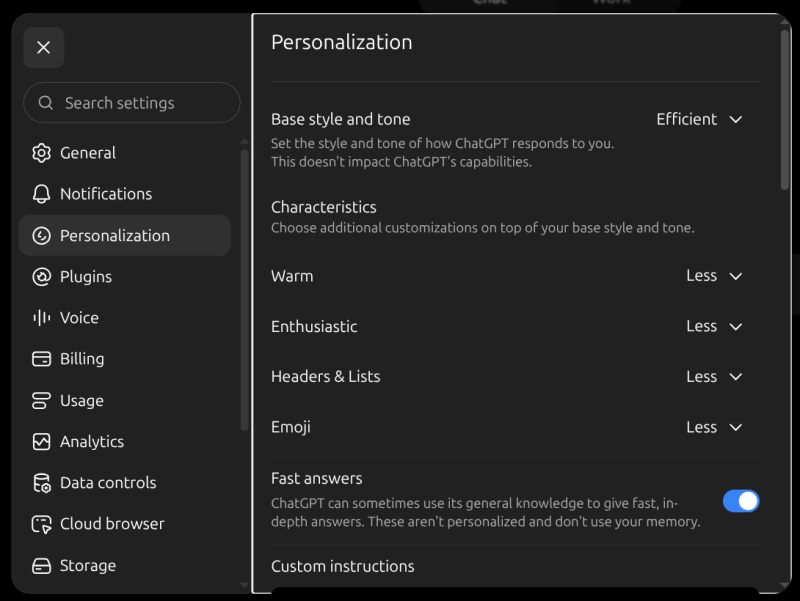
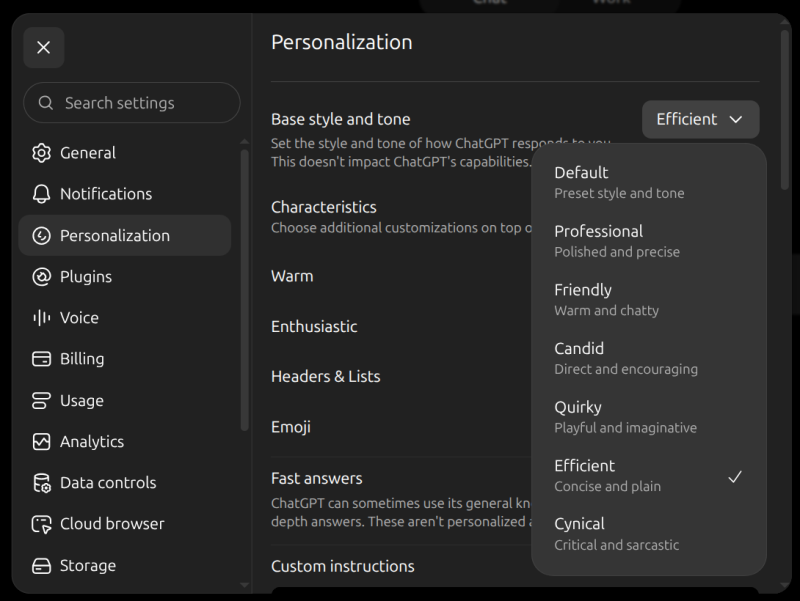
Professional, a többi less-re van állítva és a fast answers kikapcsolva
-
S_x96x_S
veterán
Na, játszok ezzel a 'latest' modellel a ChatGPT-ben. Olyan baromi hosszú, teljesen feleslegesen terjengős válaszokat ad baromi egyszerű kérdésekre is... kitöröltem a systempromptot amit anno még az 5.0-hoz írtam. Ezután is ugyan ezt csinálja.
Kérem vissza a 4.0-t azóta csak szívok vele

> Na, játszok ezzel a 'latest' modellel a ChatGPT-ben. Olyan baromi hosszú, teljesen feleslegesen terjengős válaszokat ad baromi egyszerű kérdésekre is..
A "Personalization"-ban nálad mi van beállítva ?
-
Aweriot
senior tag
Nagyobb terjedelmű feladatot még nem adtam neki, csak 'itt egy 200 oldalas md dolgozzunk vele" volt eddig.
Reggie0
Minden további nélkül vállalom, nem igazán érdekel az egésznek a lelki világa, kifizetek egy valag pénzt, működjön.
-
5leteseN
őstag
Na, játszok ezzel a 'latest' modellel a ChatGPT-ben. Olyan baromi hosszú, teljesen feleslegesen terjengős válaszokat ad baromi egyszerű kérdésekre is... kitöröltem a systempromptot amit anno még az 5.0-hoz írtam. Ezután is ugyan ezt csinálja.
Kérem vissza a 4.0-t azóta csak szívok vele
Egy ismerősöm teljesen elégedett valami megoldásával, amivel felezte-harmadolta a token-égetését!
Megpróbálom "kiszedni" belőle.
Nekem is jól jönne! -
Reggie0
titán
Na, játszok ezzel a 'latest' modellel a ChatGPT-ben. Olyan baromi hosszú, teljesen feleslegesen terjengős válaszokat ad baromi egyszerű kérdésekre is... kitöröltem a systempromptot amit anno még az 5.0-hoz írtam. Ezután is ugyan ezt csinálja.
Kérem vissza a 4.0-t azóta csak szívok vele
caveman
-
consono
nagyúr
Na, játszok ezzel a 'latest' modellel a ChatGPT-ben. Olyan baromi hosszú, teljesen feleslegesen terjengős válaszokat ad baromi egyszerű kérdésekre is... kitöröltem a systempromptot amit anno még az 5.0-hoz írtam. Ezután is ugyan ezt csinálja.
Kérem vissza a 4.0-t azóta csak szívok vele
Érdekes, mert amiket láttam statisztikákat ott a Fable-nél 3-4x kevesebb tokenból oldott meg dolgokat, az Opushoz mérten meg 10-20x kevesebbet használt.
Mondjuk nekem az egész Chat GPT borzalmasan terjengősen beszél, ebből a Gemini sokkal jobb, kár, hogy a Pro is elbutult.... -
Aweriot
senior tag
Na, játszok ezzel a 'latest' modellel a ChatGPT-ben. Olyan baromi hosszú, teljesen feleslegesen terjengős válaszokat ad baromi egyszerű kérdésekre is... kitöröltem a systempromptot amit anno még az 5.0-hoz írtam. Ezután is ugyan ezt csinálja.
Kérem vissza a 4.0-t azóta csak szívok vele
-
Reggie0
titán
Én a nemzetközi tapasztalatokból azt vontam le, hogy a Qwen3.6 és előtti LLM-ek esetén az NVPF4 kb a Q4,7-4,8-nak felel meg.
A zújaknál további trükköket vetnek be(főleg az Unsloth), de ezekhez LLM-optimalizáláson keresztül vezetett az ú, és az általuk részben átépített llama és LLM modellel jön ki az az előny, hogy az NVFP4 a tesztjeik szerint kicsivel jobb, mint a Q5K_M!
Ezeknél viszont (nem véletlenül) az LLM modell mérete mindig a "régi" NVFP4 és Q5K_M között van, tehát van VRAM-ára a (fél-)eredménynek.Én ezeket a jelenlegi állapotban félkész/menet-közbeni fejlesztéseknek tartom, amiknek a kommunikációs figyelem-felkeltő/-fenntartó (+hosszútávú marketing) céljai lehetnek inkább a kiadó csapatoknak cégeknek!
NVFP4 gyakorlatilag az MXFP4 szintejen van. Amugy ezt a nagyobb bitszamu minoseget azert erzed, mert az NVFP4 effektiven 4.5 bites, mivel surun van group/supergroup scale letarolva.
-
5leteseN
őstag
Én a nemzetközi tapasztalatokból azt vontam le, hogy a Qwen3.6 és előtti LLM-ek esetén az NVPF4 kb a Q4,7-4,8-nak felel meg.
A zújaknál további trükköket vetnek be(főleg az Unsloth), de ezekhez LLM-optimalizáláson keresztül vezetett az ú, és az általuk részben átépített llama és LLM modellel jön ki az az előny, hogy az NVFP4 a tesztjeik szerint kicsivel jobb, mint a Q5K_M!
Ezeknél viszont (nem véletlenül) az LLM modell mérete mindig a "régi" NVFP4 és Q5K_M között van, tehát van VRAM-ára a (fél-)eredménynek.Én ezeket a jelenlegi állapotban félkész/menet-közbeni fejlesztéseknek tartom, amiknek a kommunikációs figyelem-felkeltő/-fenntartó (+hosszútávú marketing) céljai lehetnek inkább a kiadó csapatoknak cégeknek!
-
Reggie0
titán
Közben nem számoltam be arról, hogy most először elégedett vagyok a DGX Sparkon látott LLM teljesítménnyel.
A Qwen3.8 Flash Next NVFP4-ben vLLM-mel 2-es MTP-vel elhozta azt az intelligenciát és sebeséget, amit már használhatónak tekintek. Az a közel 40 tok/s nem olyan rossz, mint amire emlékeztem. A Qwen3.6 35B A3B Q6 GGUF lényegesen lassabb volt, pedig a tiszta token/s sebességük hasonló (ami szintén érdekes a modellméret figyelembe vételével), de ezek szerint a nagy kontext pre-fill és egyéb architekturális sajátosságok miatt mégis gyorsabb, mindamellett, hogy lényegesen intelligensebb is. Arra gondoltam, hogy talán kevesebb tokent gondolkodik, az is segíthet. Mindenesetre többlépéses agentként sokkal hamarabb szállítja a válaszokat.
Inkább kivárom azt a 10 perces betöltést vLLM-mel, ha utána mindig ennyivel gyorsabb, mintsem llama.cpp-vel a majdnem azonnali kezdést, de folyamatosan lassabb interakciókat, ami nem is maga a token/sec sebességen bukik el.
Nekem ez így most nagy előrelépés.
Majd benchmarkold is meg, hogy mit tud, mert en azt tapasztaltam, hogy a Q4 eleg sokat ront rajta es vegeredmenyben a 27B jobban teljesitett. En a helyedben Q5 vagy Q6 hasznalnam, minthogy nvfp4-ben.
-
Reggie0
titán
-
 freeapro
senior tag
Közben nem számoltam be arról, hogy most először elégedett vagyok a DGX Sparkon látott LLM teljesítménnyel.
A Qwen3.8 Flash Next NVFP4-ben vLLM-mel 2-es MTP-vel elhozta azt az intelligenciát és sebeséget, amit már használhatónak tekintek. Az a közel 40 tok/s nem olyan rossz, mint amire emlékeztem. A Qwen3.6 35B A3B Q6 GGUF lényegesen lassabb volt, pedig a tiszta token/s sebességük hasonló (ami szintén érdekes a modellméret figyelembe vételével), de ezek szerint a nagy kontext pre-fill és egyéb architekturális sajátosságok miatt mégis gyorsabb, mindamellett, hogy lényegesen intelligensebb is. Arra gondoltam, hogy talán kevesebb tokent gondolkodik, az is segíthet. Mindenesetre többlépéses agentként sokkal hamarabb szállítja a válaszokat.
Inkább kivárom azt a 10 perces betöltést vLLM-mel, ha utána mindig ennyivel gyorsabb, mintsem llama.cpp-vel a majdnem azonnali kezdést, de folyamatosan lassabb interakciókat, ami nem is maga a token/sec sebességen bukik el.
Nekem ez így most nagy előrelépés.
A végleges (0731) Deepseek V4 Flash modellek is nézted?
-
S_x96x_S
veterán
upgradelték ( ~ javították ) az AAI indexet ... v.4.2
https://x.com/ArtificialAnlys/status/2096001986110099767https://artificialanalysis.ai/leaderboards/models
- Fable 5.1 :57
- GPT-6-Astra : 55
....
- Qwen3.8-Flash-Next : 46
- Qwen3.8 27B (xhigh) : 41az új AAI v4.2 - nel
A qwen 3.8 27b visszaesett 52 -rol 41-re -
consono
nagyúr
-
Geller72
nagyúr
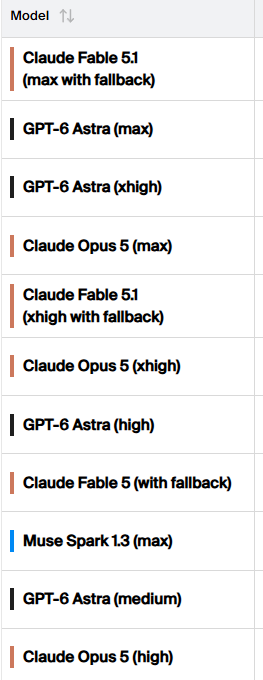
upgradelték ( ~ javították ) az AAI indexet ... v.4.2
https://x.com/ArtificialAnlys/status/2096001986110099767https://artificialanalysis.ai/leaderboards/models
- Fable 5.1 :57
- GPT-6-Astra : 55
....
- Qwen3.8-Flash-Next : 46
- Qwen3.8 27B (xhigh) : 41Érdekes, de a 6-os Astra-nál nem látok itt a táblázatban Ultra setupos mérést, pedig van olyan setupja is..
-
S_x96x_S
veterán
56
Qwen3.8-Flash-Next : 56 -os Artificial Analysis Index.
https://artificialanalysis.ai/leaderboards/models
Claude Opus 5 (max) : 63 ( ez a top érték )
Kimi K3 (max) : 60
GLM-5.3 (max) : 60
Qwen3.8 2.4T A95B : 58
GLM-5.3-Flash 320B-A18B : 57 ( Ox Alpha )
Qwen3.8-Flash-Next : 56 <-------
DeepSeek V4Pro0813 (max): 53
Qwen3.8 27B (xhigh) : 52
GLM-5.2 (max) : 52
DeepSeekV4Flash0731(max: 52upgradelték ( ~ javították ) az AAI indexet ... v.4.2
https://x.com/ArtificialAnlys/status/2096001986110099767https://artificialanalysis.ai/leaderboards/models
- Fable 5.1 :57
- GPT-6-Astra : 55
....
- Qwen3.8-Flash-Next : 46
- Qwen3.8 27B (xhigh) : 41 -
 Citroware
addikt
Közben nem számoltam be arról, hogy most először elégedett vagyok a DGX Sparkon látott LLM teljesítménnyel.
A Qwen3.8 Flash Next NVFP4-ben vLLM-mel 2-es MTP-vel elhozta azt az intelligenciát és sebeséget, amit már használhatónak tekintek. Az a közel 40 tok/s nem olyan rossz, mint amire emlékeztem. A Qwen3.6 35B A3B Q6 GGUF lényegesen lassabb volt, pedig a tiszta token/s sebességük hasonló (ami szintén érdekes a modellméret figyelembe vételével), de ezek szerint a nagy kontext pre-fill és egyéb architekturális sajátosságok miatt mégis gyorsabb, mindamellett, hogy lényegesen intelligensebb is. Arra gondoltam, hogy talán kevesebb tokent gondolkodik, az is segíthet. Mindenesetre többlépéses agentként sokkal hamarabb szállítja a válaszokat.
Inkább kivárom azt a 10 perces betöltést vLLM-mel, ha utána mindig ennyivel gyorsabb, mintsem llama.cpp-vel a majdnem azonnali kezdést, de folyamatosan lassabb interakciókat, ami nem is maga a token/sec sebességen bukik el.
Nekem ez így most nagy előrelépés.
-
Aweriot
senior tag
-
Citroware
addikt
Mert a felhasználók 1%-ába tartozol azzal, hogy tudod, hogy létezik 5.5, 5.6 és 6.
-
Aweriot
senior tag
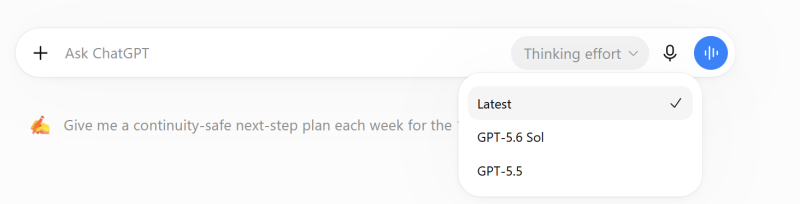
Én amúgy értékelném hogyha az OpenAI ezt a folyamatos user hülyének nézést befejezné. Az egy dolog hogy a mobil appból a modelválltást a beállítások menübe száműzték, de most már ez is? Miért nem lehet egy olyan kapcsoló, hogy 'figyu, tudom mit csinálok, ne nézz már ostobának légyszi' -
Geller72
nagyúr
-
Aweriot
senior tag
-
dippe
tag
> 256GB 1.2 TB/s nem hangzik rossznak.
állítólag az 512GB-os verziót később ( október végén? ) jelentik be.
"Apple says the Mac Studio with the M5 Ultra chip and 512GB of RAM will be coming in "late October," with U.S. pricing expected to start well above the $10,000 mark. "> . De pl. az NPU teljesítménye elég ködös, azt ígérik hogy 4x lesz gyorsabb mint az M3 ultra. De ez vajon mit fog a gyakorlatban jelenteni
Meg kell várni a teszteket,
de M3 Ultra : 32 magos NPU = 38 TOPS.szerintem az NPU -t
elsősorban az operációs rendszer használja, főleg képfelismerésre, hangfeldolgozásra, stb.---
a GPU-ban is van Neural Accelerator - és szerintem erre irták a 4.5x AI sebesség növekedést.
"The GPU incorporates a Neural Accelerator in every core, delivering up to 4.5x the peak GPU AI compute of M3 Ultra. "Köszi, ez nem volt meg: "a GPU-ban is van Neural Accelerator". Így már reálisabb lehet a gyorsulás.
512-esnek sok értelmét nem látom, inkább vennék 2db 256-ost. Már ha nyernék a lottón... -
S_x96x_S
veterán
Windows Agentik -
"Announcing Project Zenith: The ready-to-code Windows experience on developer-class devices"
"Today, we’re taking the next step with Project Zenith, a ready-to-code distraction-free Windows experience on developer-class devices with 64 GB+ unified memory and 250+ GB/s memory bandwidth, so developers can jump right in.
Project Zenith will first become available with AMD’s Ryzen AI Halo, with more devices from our OEM and silicon partners available in the coming months."
https://blogs.windows.com/windowsdeveloper/2026/09/04/announcing-project-zenith-the-ready-to-code-windows-experience/ -
S_x96x_S
veterán
> 256GB 1.2 TB/s nem hangzik rossznak.
állítólag az 512GB-os verziót később ( október végén? ) jelentik be.
"Apple says the Mac Studio with the M5 Ultra chip and 512GB of RAM will be coming in "late October," with U.S. pricing expected to start well above the $10,000 mark. "> . De pl. az NPU teljesítménye elég ködös, azt ígérik hogy 4x lesz gyorsabb mint az M3 ultra. De ez vajon mit fog a gyakorlatban jelenteni
Meg kell várni a teszteket,
de M3 Ultra : 32 magos NPU = 38 TOPS.szerintem az NPU -t
elsősorban az operációs rendszer használja, főleg képfelismerésre, hangfeldolgozásra, stb.---
a GPU-ban is van Neural Accelerator - és szerintem erre irták a 4.5x AI sebesség növekedést.
"The GPU incorporates a Neural Accelerator in every core, delivering up to 4.5x the peak GPU AI compute of M3 Ultra. " -
Reggie0
titán
Apple PP-ben eleg gyenge volt dgx sparkhoz viszonyitva is, valoszinuleg erre gondolnak.
-
S_x96x_S
veterán
nem lesz olcsó.
"AMD Introduces Threadripper Halo Station at IFA 2026"
https://www.techpowerup.com/352347/amd-introduces-threadripper-halo-station-at-ifa-2026
"a liquid-cooled workstation built around the
- 96-core Threadripper PRO 9995WX CPU codenamed "Shimada Peak"
- and up to four AMD Instinct MI350P accelerators. ( each MI350P card features 144 GB of HBM3E running at 4 TB/s, )
"Vagyis 2db MI350P kártya = 288 GB of HBM3E memory ( 4 TB/s )
-
 Komplikato
veterán
Az majdnem olyan vicces, mint amikor veszel egy Asus Pro Art workstation (Threadripper) alaplapot és rájössz, hogy kb. ez az egyetlen a versenyzők közül, amiben a slotokon NEM működik a bifurkáció.
-
dippe
tag
Az Apple M5 ultra-ról van megbízható infó a honlapon kívül?
5M Ft-ért 256GB 1.2 TB/s nem hangzik rossznak. De pl. az NPU teljesítménye elég ködös, azt ígérik hogy 4x lesz gyorsabb mint az M3 ultra. De ez vajon mit fog a gyakorlatban jelenteni?


![;]](http://cdn.rios.hu/dl/s/v1.gif) Na jó: a zEMMÍ) egy állítólag jól teszt-sort, amivel a kimaxolt beállításokkal(10 próbálkozásból) ez lett a legjobb eredményünk 3x200 kérdésnél a Qwen"3.8"-9B-Q8-nel:
 Lehet ahhoz megeri egy olcsobb gpu-t venni, mint az CMP 170HX, mert az nem idealis hozza, mivel a sok memobol annyira nem lehet profitalni ennel a modelnel, mint a nagyobb szamitasi kapacitasbol. Sajnos elegge beveri a fejet a compute limitbe a CMP 170HX-en. A jelenlegi arak mellett egy 4090 vagy egy 4080 super jobb valasztas hozza.


 ez a licenszing fel sem tűnt. Közeledik az ingyenes "jó" modell aranykor vége is?


 :


 (Nem a t/s-ben, hanem a bench pontszámában).


 /


Új hozzászólás Aktív témák
-
Fórumok
LOGOUT - lépj ki, lépj be!
LOGOUT reakciók Monologoszféra FototrendGAMEPOD - játék fórumok
PC játékok Konzol játékok MobiljátékokMobilarena - mobil fórumok
Okostelefonok Mobiltelefonok Okosórák Autó+mobil Üzlet és Szolgáltatások Mobilalkalmazások Tartozékok, egyebek Mobilarena blogokPROHARDVER! - hardver fórumok
Notebookok TV & Audió Digitális fényképezés Alaplapok, chipsetek, memóriák Processzorok, tuning Hűtés, házak, tápok, modding Videokártyák Monitorok Adattárolás Multimédia, életmód, 3D nyomtatás Nyomtatók, szkennerek Tabletek, E-bookok PC, mini PC, barebone, szerver Beviteli eszközök Egyéb hardverek PROHARDVER! BlogokIT café - infotech fórumok
Infotech Hálózat, szolgáltatók OS, alkalmazások SzoftverfejlesztésFÁRADT GŐZ - közösségi tér szinte bármiről
Tudomány, oktatás Sport, életmód, utazás, egészség Kultúra, művészet, média Gazdaság, jog Technika, hobbi, otthon Társadalom, közélet Egyéb Lokál PROHARDVER! interaktív
- Roland861010: Negyven előtt: amikor már a pihenést is luxusnak érzed
- iPhone topik
- Formula-1
- Jövedelem
- Kerékpárosok, bringások ide!
- Star Trek Online -=MMORPG=-
- Milyen egeret válasszak?
- Geller72: Az MS Seed szervert üzemeltet a gépeden és lehet hogy nem is tudsz róla?
- Autós topik
- Intel Core i5 / i7 / i9 "Alder Lake-Raptor Lake/Refresh" (LGA1700)
- További aktív témák...
- Újszerű MacBook Air 13,3" M1 (2020) - 8GB - 256GB - MAGYAR - 112 Ciklus - 96% akku
- iPhone 16 Pro Max 256GB független 90% akksi
- Prémium Félkonfig - I9-10900k, Z490-E, 32GB DDR4, 1TB, 850W, H500M
- Sigma APS-C objektívek (10-20, 17-50, 50-200) Canon EF-S bejonettre
- Dell Latitude 5430 Intel prémium üzleti laptop. I5 (12.gen 123U ) 4Ghz RAM 16GB, SSD256 GB NVMe
- 27% - GIGABYTE B650 GAMING X AX V2 Alaplap
- Eredeti Lenovo USB-C 65W töltők (újszerűek) (ADLX65YSCC3A)
- 0 perces Apple Watch Series 11 46mm GPS, Jet Black, M/L, 12 hónap garancia
- Lenovo ThinkPad P14s AMD Ryzen 5 PRO 5650U 16GB RAM 512SSD Garancia AMD Graphics 4GB
- Dell Latitude 3320,13.3",FHD,i5-1135G7,8GB DDR4,256GB SSD,WIN11